Задание 3.2 · 2 балла
Бустинг на оттоке: почему ρ важен
Сравниваем одно дерево, бустинг с ρ = 1 и бустинг с подбором ρ. С подбором качество сильно выше, и это можно объяснить точно.
Классификация через регрессию
Бустинг с MSE учится предсказывать число около 0 или 1. Выход сравниваем с порогом 0.5 функцией decide_class из шаблона: ≥ 0.5 значит «уйдёт».
Сколько деревьев
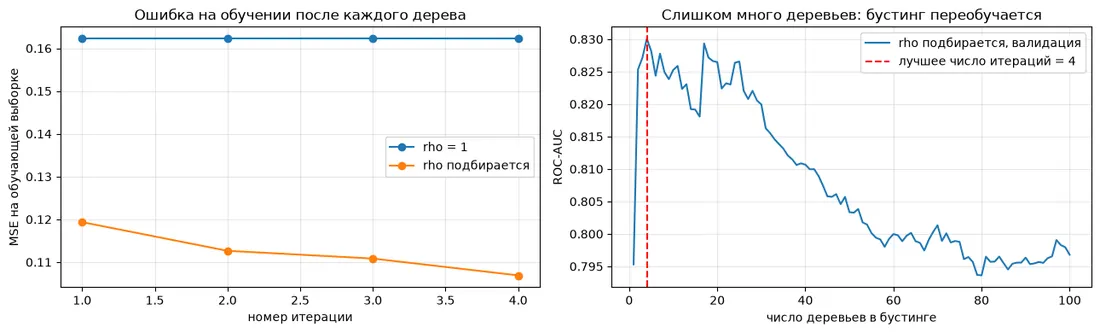
Число итераций подобрано на валидации (четверть train), test не трогали. Шаг тут большой, поэтому бустинг учится очень быстро: лучший ROC-AUC на валидации уже после 4 деревьев, а дальше переобучение.
Результат
| Модель | ROC-AUC | F1 | accuracy | MSE | обучение |
|---|---|---|---|---|---|
| одно дерево глубины 3 | 0.795 | 0.375 | 0.838 | 0.119 | ~0.01 с |
| бустинг, ρ = 1 | 0.433 | 0 | 0.797 | 0.162 | ~0.04 с |
| бустинг, ρ подбирается | 0.850 | 0.515 | 0.855 | 0.107 | ~0.1 с |
Почему ρ = 1 вообще не учится
- Разброс внутри листа тоже не меняется (ко всем объектам листа прибавили одно число), поэтому сумма квадратов ошибок остаётся ровно прежней.
- Прогнозы при этом прыгают вверх-вниз, и порядок клиентов по риску получается хуже случайного: ROC-AUC 0.433 < 0.5.
- Если бы потеря была ½(y - f)², как в тексте задания, градиент был бы (f - y) и ρ = 1 был бы правильным шагом. Подбор ρ автоматически исправляет масштаб градиента, для этого он и нужен.
Время
- Одно дерево быстрее всего: строится один раз.
- Бустинг строит несколько деревьев подряд.
- Подбор ρ в 2-3 раза медленнее ρ = 1: на каждом шаге считаются потери для 201 значения ρ (матрица 201 × 8000). Точные секунды зависят от компьютера.
Почему подбор всё время даёт ρ = 0.5?
В коде перебираются все ρ от -1 до 1, и минимум потерь каждый раз оказывается в 0.5 из-за двойки в градиенте.
Вопросы на защите
Почему при ρ = 1 ROC-AUC меньше 0.5?
Прогнозы «качаются»: после чётного шага одни клиенты завышены, после нечётного занижены. Порядок клиентов по оценке путается, получается хуже случайного.
Почему лучших итераций всего 4?
Шаг 0.5 при остатке 2(y - f) это полный шаг без замедления (learning rate = 1). Модель быстро подстраивается под train, и после нескольких деревьев начинает переобучаться. Можно было бы взять маленький шаг и больше деревьев, но условие этого не требует.
Почему выход называют логитами?
Так в условии. На самом деле это число, похожее на вероятность ухода: мы учились предсказывать 0/1 через MSE. Настоящие логиты были бы при логистической потере.
Бустинг лучше леса?
На этих данных лес дал ROC-AUC 0.859, бустинг 0.850, это близко. Бустинг учится за доли секунды, лес за секунды. Бустинг можно улучшить маленьким шагом и большим числом деревьев.