Задание 3.1 и 3.2 · 3 балла за класс
Градиентный бустинг и синус
Строим деревья по очереди: каждое новое учится исправлять ошибку всех предыдущих. Проверяем на зашумлённом синусе, где одно маленькое дерево явно не справляется.
- Бустинг
- Последовательность моделей, каждая исправляет ошибки суммы предыдущих.
- Пенёк, неглубокое дерево
- Дерево глубины 1-3. Само по себе слабое, зато не переобучается.
- f₀
- Начальный прогноз: одна константа для всех, у нас среднее y.
- Остатки r
- Антиградиент потерь. Для MSE это 2(y - f): удвоенная текущая ошибка.
- ρ (ро)
- Длина шага: с каким множителем прибавить новое дерево.
Алгоритм
Код
class GradientTreeBoosting:
    def __init__(self, loss='MSE', iterations=10, const_p=False, **tree_kwargs):
        self.loss, self.loss_gradient = losses[loss]
        self.iterations = iterations
        self.const_p = const_p
        self.tree_kwargs = tree_kwargs
        self.trees = []
        self.rhos = []
self.train_loss = []losses[loss]из словаря берём пару (функция потерь, её градиент) по названию 'MSE', 'MAE' или 'lq'.const_pTrue: ρ всегда 1. False: ρ подбирается каждый шаг.**tree_kwargsвсё остальное (max_depth=3, random_state=42) уходит вDecisionTreeRegressor.trees, rhosсписок обученных деревьев и их шагов, это и есть модель.train_lossистория ошибки для графика.
    def fit(self, X, y):
        y = np.asarray(y, dtype=float)
        self.f0 = np.mean(y)
        f = np.full(len(y), self.f0)
        self.trees, self.rhos, self.train_loss = [], [], []
        rho_grid = np.linspace(-1, 1, 201)
        for _ in range(self.iterations):
            residuals = -self.loss_gradient(y, f)
            tree = DecisionTreeRegressor(**self.tree_kwargs).fit(X, residuals)
            h = tree.predict(X)
            if self.const_p:
                rho = 1.0
            else:
                rho = rho_grid[np.argmin(self.loss(y, f + rho_grid[:, None] * h))]
            f = f + rho * h
            self.trees.append(tree)
            self.rhos.append(rho)
            self.train_loss.append(self.loss(y, f))
        return self
np.full(len(y), self.f0)массив, где у всех объектов прогноз = среднее.np.linspace(-1, 1, 201)201 кандидат ρ с шагом 0.01: условие просит брать ρ из чисел от -1 до 1.residuals = -self.loss_gradient(y, f)антиградиент: куда двигать прогноз каждого объекта.DecisionTreeRegressor(...).fit(X, residuals)дерево учится предсказывать не y, а остатки.rho_grid[:, None] * hматрица 201 × n: строка k это прогноз f + ρₖ·h.self.loss(...)благодаряaxis=-1даёт 201 число,np.argminномер лучшего. Всё без цикла по ρ.f = f + rho * hобновляем прогноз.
    def predict(self, X):
        f = np.full(len(X), self.f0)
        for tree, rho in zip(self.trees, self.rhos):
            f = f + rho * tree.predict(X)
return f- Начинаем с константы и по очереди прибавляем вклад каждого дерева, как требует условие («последовательно применить»).
Синус
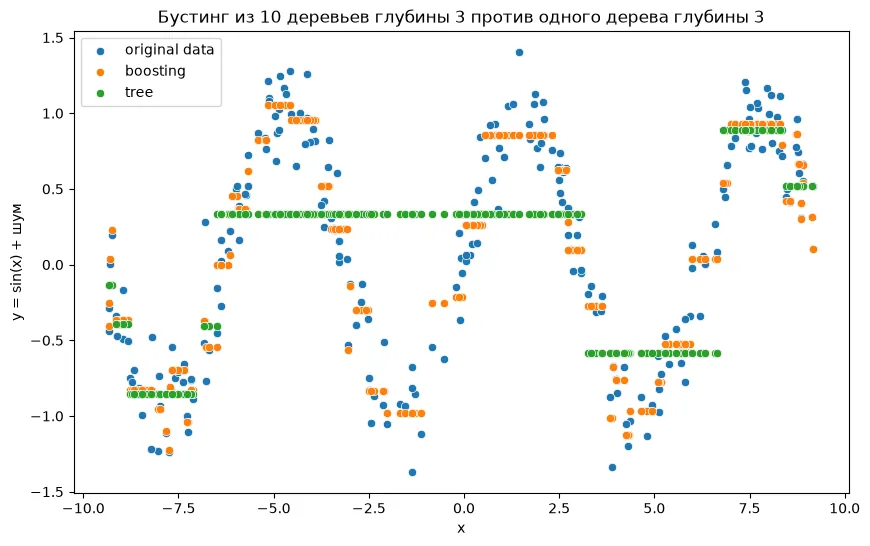
| Модель | MSE |
|---|---|
| одно дерево глубины 3 | 0.236 |
| бустинг, ρ подбирается | 0.026 |
| бустинг, ρ = 1 | 0.524 (хуже одного дерева!) |
Подбор ρ каждый раз выбрал ρ = 0.5. Ошибка 0.026 близка к шуму: 0.2² = 0.04, лучше на этих точках почти нельзя.
Попробуй руками
Тот же бустинг деревьями глубины 3 на синусе. Нажимай «Шаг» и смотри, как жёлтая линия приближается к синусу. Потом переключи режим на «ρ = 1» и сравни: линия начинает метаться.
Нижний график: текущая ошибка y - f каждой точки (оранжевые) и то, что выучит следующее дерево (зелёная ступенчатая линия). С каждым шагом ошибки прижимаются к нулю.
На чём учится каждое новое дерево бустинга?
Новое дерево предсказывает, куда и насколько сдвинуть текущий прогноз. Потом его ответ умножается на ρ и прибавляется.
Вопросы на защите
Почему деревья в бустинге неглубокие?
Каждое дерево исправляет лишь часть ошибки, а вместе они дают сложную модель. Глубокие деревья быстро подстраиваются под шум и переобучаются.
Чем бустинг отличается от леса?
Лес строит деревья независимо и усредняет, это уменьшает случайную ошибку. Бустинг строит деревья по очереди, каждое исправляет ошибку суммы предыдущих, это уменьшает систематическую ошибку.
Где цикл по ρ?
Его нет: потери для всех 201 значений ρ считаются одной матричной операцией, потом argmin.
Почему ρ всегда 0.5?
Дерево учится на 2(y - f), то есть на удвоенной ошибке. Чтобы исправить ошибку ровно, нужно взять половину: ρ = 0.5.