Задание 2.1 · 2 балла
Случайный лес
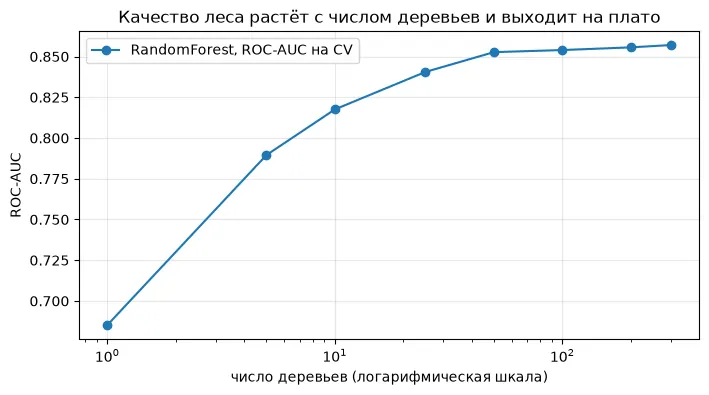
Строим 200 деревьев, каждое на своей случайной версии данных и со случайными признаками в каждом узле, и даём им проголосовать. Задача: уйдёт ли клиент из банка.
Данные об оттоке
10 000 клиентов банка, ушли 20.4% (Exited = 1). Классы несбалансированы: оставшихся вчетверо больше.
| Столбец | Что сделали | Почему |
|---|---|---|
RowNumber, CustomerId | удалили | номера, причин ухода в них нет |
Surname | удалили | 2932 разные фамилии, только переобучение |
Gender | Male = 1, Female = 0 | дерево понимает только числа |
Geography | one-hot: 3 столбца 0/1 | у стран нет порядка, номера 0/1/2 его бы придумали |
- One-hot
- Вместо одного столбца «страна» три: «Франция?», «Германия?», «Испания?», в каждом 0 или 1.
- Бэггинг
- Учим много одинаковых моделей на разных случайных подвыборках и усредняем.
- Бутстрап
- Случайная выборка того же размера с возвращением: кто-то попадёт дважды, кто-то ни разу (около 37%).
- max_features
- Сколько случайных признаков дерево смотрит в каждом узле. Эвристика из задания: k = √d.
- Голосование
- Каждое дерево говорит «уйдёт / не уйдёт», побеждает большинство. Доля голосов это оценка вероятности.
Поиграй: бутстрап
10 клиентов. Тянем 10 раз с возвращением: кто-то попадёт дважды, кто-то ни разу. Так у каждого дерева своя версия данных.
все клиенты (пунктир = не попал в выборку)
что вытянули
Поиграй: почему среднее деревьев лучше
Каждое серое дерево глубокое и обучено на своём бутстрапе. Жёлтая линия: их среднее. Двигай число деревьев.
Код: RandomForest
class RandomForest:
    def __init__(self, n_estimators=100, task='classification', max_features='sqrt', random_state=None, **tree_kwargs):
        ...

    def fit(self, X, y):
        X, y = np.asarray(X), np.asarray(y)
        rng = np.random.default_rng(self.random_state)
        tree_class = DecisionTreeClassifier if self.task == 'classification' else DecisionTreeRegressor
        if self.task == 'classification':
            self.classes_ = np.unique(y)
        self.trees = []
        for _ in range(self.n_estimators):
            rows = rng.integers(0, len(X), size=len(X))  # бутстрап
            tree = tree_class(max_features=self.max_features, random_state=int(rng.integers(2**31 - 1)), **self.tree_kwargs)
            self.trees.append(tree.fit(X[rows], y[rows]))
return self**tree_kwargs«всё остальное»: критерий остановки и функционал (max_depth,criterion...) передаём деревьям как есть.np.random.default_rng(self.random_state)генератор случайных чисел с зерном: при каждом запуске одинаковый лес.tree_classдля классификации дерево-классификатор, для регрессии дерево-регрессор (это задание 2.3).rng.integers(0, len(X), size=len(X))m случайных номеров строк от 0 до m-1, повторы разрешены. Это и есть бутстрап.max_features=...дерево sklearn в каждом узле выбирает случайные k признаков и ищет лучший вопрос только среди них. Остальные признаки не выброшены, они участвуют в других узлах.random_state=int(rng.integers(...))у каждого дерева своё зерно, иначе все деревья выбирали бы одинаковые признаки.
    def predict_proba(self, X):
        votes = np.array([tree.predict(np.asarray(X)) for tree in self.trees])  # (деревья, объекты)
        return (votes[:, :, None] == self.classes_).mean(axis=0)

    def predict(self, X):
        if self.task == 'regression':
            return np.mean([tree.predict(np.asarray(X)) for tree in self.trees], axis=0)
return self.classes_[self.predict_proba(X).argmax(axis=1)]votesтаблица: строка = дерево, столбец = клиент, в клетке ответ дерева.votes[:, :, None] == self.classes_для каждого класса отмечаем, кто за него голосовал;.mean(axis=0)доля деревьев. Если 150 из 200 сказали «уйдёт», вероятность 0.75.argmaxпобеждает класс с наибольшей долей голосов.- Для регрессии ответ это среднее прогнозов всех деревьев.
DecisionTreeClassifier), это разрешено условием. Бутстрап, случайные зёрна, голосование и среднее написаны сами. RandomForestClassifier используется только для сравнения.Метрика: почему ROC-AUC
- ROC-AUC
- Вероятность, что случайный ушедший клиент получит от модели оценку выше, чем случайный оставшийся. 0.5 = монетка, 1 = идеально. Не зависит ни от порога, ни от доли классов.
- precision
- Из тех, кого модель назвала «уйдёт», сколько правда ушли.
- recall
- Из всех, кто правда ушёл, скольких модель нашла.
- F1
- Среднее гармоническое precision и recall: высокое, только если обе хорошие. Зависит от порога 0.5.
- Кросс-валидация (CV)
- Train делим на 3 части, по очереди учим на двух и проверяем на третьей, качество усредняем. Test при подборе не трогаем.
Выбрали ROC-AUC: он честен при дисбалансе и оценивает главное для банка, умение упорядочить клиентов по риску (кого обзванивать первым). F1, precision и recall показаны рядом.
Поиграй: порог и метрики
20 клиентов, отсортированы по оценке модели (число = оценка в процентах). Оранжевые правда ушли (4 из 20, как 20% в данных). Обведённых модель назвала «уйдёт».
Подбор гиперпараметров
Сетка из 48 вариантов, каждый на 3 фолдах по 50 деревьев: критерий (gini, entropy) × max_depth (нет, 6, 10, 14) × min_samples_leaf (1, 5, 10) × max_features (√12 ≈ 3 или 60% = 7).
Итог на test
| Модель | ROC-AUC | F1 | precision | recall | accuracy | время |
|---|---|---|---|---|---|---|
| наш лес | 0.859 | 0.571 | 0.782 | 0.450 | 0.863 | ~3.4 с |
| лес sklearn | 0.860 | 0.567 | 0.769 | 0.450 | 0.861 | ~2.3 с |
| одно дерево | 0.806 | 0.563 | 0.650 | 0.496 | 0.843 | 0.03 с |
| «никто не уйдёт» | 0.500 | 0 | 0 | 0 | 0.797 |
- Наш лес совпадает с sklearn по качеству (разница в третьем знаке), чуть медленнее: у нас цикл Python по деревьям, sklearn на C.
- Лес лучше одного дерева по ROC-AUC: 0.859 против 0.806.
- Recall 0.45: при пороге 0.5 находим меньше половины уходящих. Если важнее найти больше, порог снижают; ROC-AUC от порога не зависит.
Ушли 20% клиентов. Модель всем отвечает «не уйдёт». Какая у неё accuracy?
Она права для всех 80% оставшихся. Высокая accuracy при нулевой пользе: поэтому для подбора взят ROC-AUC.
Что делает max_features в дереве леса?
Признаки не выбрасываются: в другом узле выпадут другие. Это делает деревья разными, и голосование работает лучше.
Вопросы на защите
Почему не accuracy?
Классы 80/20. Модель, которая всем отвечает «не уйдёт», получает 0.797, не найдя ни одного уходящего. ROC-AUC у неё 0.5, то есть сразу видно, что она бесполезна.
Зачем случайные признаки в каждом узле?
Иначе все деревья начинали бы с одного и того же сильного признака (возраст) и были бы похожи. Похожие деревья ошибаются одинаково, и усреднение не помогает. Случайность делает деревья разными.
Лучшее max_features = 0.6, а в задании √d. Это нарушение?
Нет: √d это эвристика по умолчанию, и она была в сетке. Задание просит подобрать гиперпараметры, на наших данных 7 признаков из 12 дали ROC-AUC чуть выше.
Сколько объектов не попадает в бутстрап?
Примерно 37%: вероятность ни разу не попасть при m выборах равна (1 - 1/m)^m ≈ 1/e ≈ 0.37.
Почему лес лучше дерева?
Глубокое дерево сильно зависит от случайностей выборки. Деревья леса ошибаются в разных местах, при голосовании ошибки гасятся, а общая закономерность остаётся.