Задание 1.2 · входит в 5 баллов
Дерево для регрессии
То же дерево, но ответ теперь число: сколько лет в среднем живут в стране. Главное здесь не код (меняются две строки), а честная проверка и выбор метрик.
Данные
2307 строк: страна и год (2000-2019, 179 стран). Пропусков и дубликатов нет.
| Признак | Что это |
|---|---|
Health_Expenditure_Per_Capita | расходы на здравоохранение на человека, $ |
Tertiary_School_Enrollment | сколько молодых людей учится в вузах, % |
Urban_Population_Rate | доля горожан, % |
Population_Density | людей на км² |
PM25_AirPollution | загрязнение воздуха мелкой пылью |
Political_Stability_Index | индекс политической стабильности (от -3 до 2) |
Life_Expectancy | цель: ожидаемая продолжительность жизни, лет |
Предобработка и почему так
| Столбец | Что сделали | Почему |
|---|---|---|
index | удалили | номер строки, не свойство страны |
Country Name/Code | удалили из признаков | иначе дерево запомнит «Япония = 84», а не связь с медициной |
Year | '2003 [YR2003]' → 2003 | дерево понимает только числа |
Масштабировать и логарифмировать не нужно: дерево задаёт вопрос «x < t?», а если все значения, например, поделить на 1000, порядок не изменится и деления будут те же.
life_clean = life.drop(columns=['index', 'Country Name', 'Country Code'])
life_clean['Year'] = life_clean['Year'].str[:4].astype(int)  # '2003 [YR2003]' -> 2003
life_X = life_clean.drop(columns='Life_Expectancy')
life_y = life_clean['Life_Expectancy']
life_groups = life['Country Code']drop(columns=[...])убирает столбцы..str[:4]первые 4 символа текста («2003»),.astype(int)превращает в число.life_Xпризнаки,life_yцель.life_groupsкод страны, нужен только чтобы делить на train/test по странам.
Честная проверка: делим по странам
У каждой страны до 19 строк, соседние годы почти одинаковы. Если делить строки случайно, в test попадёт «Франция 2010», а в train «Франция 2009 и 2011»: модель просто узнаёт страну.
splitter = GroupShuffleSplit(n_splits=1, test_size=0.25, random_state=42)
train_idx, test_idx = next(splitter.split(life_X, life_y, groups=life_groups))GroupShuffleSplitделит не строки, а группы (страны): 25% стран целиком уходят в test.next(...)берём первое (и единственное) разбиение. Вышло: train 1687 строк из 134 стран, test 620 строк из 45 стран.
Код: TreeRegressor
class TreeRegressor(Tree):
    def __init__(self, max_depth=None, min_samples_leaf=1, max_leaves=None, min_impurity=0.0):
        super().__init__('mse', max_depth, min_samples_leaf, max_leaves, min_impurity)

    def leaf_value(self, y):
        return np.mean(y)
class TreeRegressor(Tree)наследование: берём всё отTreeи меняем только нужное.super().__init__('mse', ...)вызываем конструкторTree, но беспорядок теперь MSE.leaf_valueответ листа: не самый частый класс, а среднее.
Всё остальное (поиск порога, IG, остановка, очередь листьев, predict) работает без изменений: IG с MSE это «насколько уменьшилась дисперсия».
Критерии остановки с поправкой на регрессию
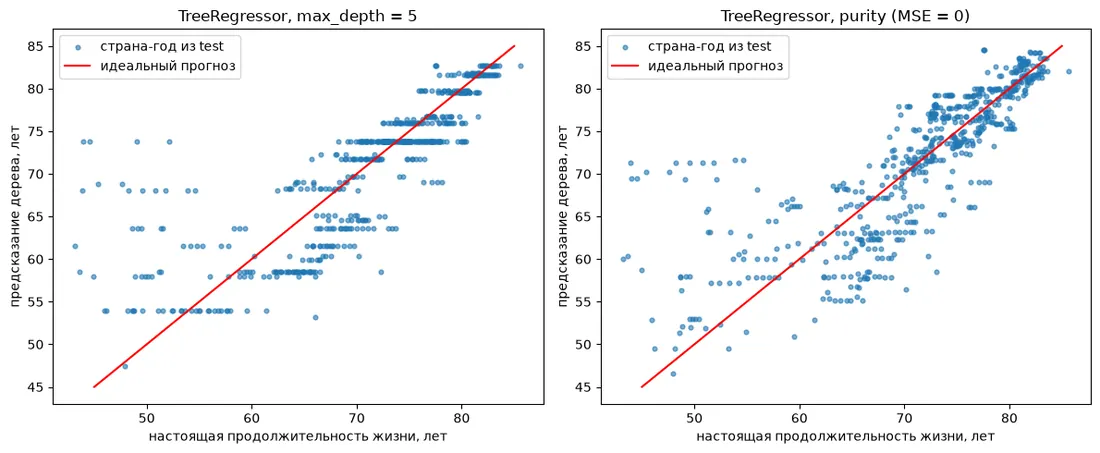
Purity в регрессии значит «все числа в листе равны» (MSE = 0). На непрерывных числах так бывает почти только в листе из одного объекта: вышло 1673 листа на 1687 строк, дерево зазубрило выборку. Поэтому добавлен вариант с допуском: не делить лист, если MSE ≤ 1, то есть разброс около ±1 года.
Поиграй: глубина и переобучение
Белые точки: train (по ним учится дерево). Голубые: test (их дерево не видит). Двигай глубину и смотри на две ошибки.
Метрики (нужно минимум 3, взяли 4)
- MAE
- Средняя ошибка в годах: среднее |правда - прогноз|. Самая понятная.
- RMSE
- Корень из среднего квадрата ошибки, тоже в годах. Сильнее наказывает крупные промахи.
- MAPE
- Средняя ошибка в процентах от правильного ответа.
- R²
- Доля разброса, которую объясняет модель: 0 = как «всегда отвечать среднее», 1 = идеально.
| Критерий | Листьев | MAE | RMSE | MAPE % | R² |
|---|---|---|---|---|---|
| max_depth = 5 | 32 | 3.17 | 4.97 | 5.05 | 0.686 |
| min_samples_leaf = 5 | 275 | 3.49 | 5.36 | 5.50 | 0.635 |
| max_leaves = 5 | 5 | 3.62 | 5.49 | 5.74 | 0.618 |
| purity (MSE = 0) | 1673 | 3.57 | 5.33 | 5.60 | 0.639 |
| purity (MSE ≤ 1) | 211 | 3.53 | 5.26 | 5.56 | 0.648 |
- Лучшее дерево глубины 5: ошибка в среднем 3.2 года (5%), объясняет 69% разброса.
- RMSE (4.97) заметно больше MAE (3.17): есть отдельные страны с ошибкой больше 10 лет, они видны на графике далеко от красной линии.
- С sklearn совпадает число листьев везде, а при 5 листьях совпадают и все метрики.
Почему при случайном делении строк R² вырос до 0.861?
Это утечка: признаки одной страны в соседние годы почти одинаковы. Честная проверка требует незнакомых стран.
Ответ листа в TreeRegressor это...
Среднее минимизирует MSE в листе. Поэтому leaf_value переопределён как np.mean(y).
Вопросы на защите
Зачем 4 метрики, а не одна?
MAE понятна в годах, RMSE показывает крупные промахи, MAPE даёт проценты, R² сравнивает с простым средним и не зависит от единиц. Вместе они дают полную картину.
Почему не масштабировал признаки?
Дерево сравнивает признак с порогом. Монотонное преобразование не меняет порядок значений, значит, и деления, и прогноз будут те же.
Чем TreeRegressor отличается от Tree?
Двумя вещами: беспорядок считается через MSE, а ответ листа это среднее, а не самый частый класс. Остальной код общий.
Почему удалил страну, она же важна?
Страна это идентификатор: модель запоминала бы ответ для конкретной страны. Нам нужна зависимость от свойств страны, которая работает и для новых стран.